
Microsoft merilis pratinjau pengembang RDMA over USB4 untuk Windows. Beberapa PC Windows yang disambungkan dengan kabel USB4 biasa dapat menggabungkan memori dan GPU masing-masing untuk menjalankan satu model bahasa besar lokal, tanpa kartu jaringan RDMA khusus, tanpa switch, dan tanpa driver pihak ketiga.
Fitur ini ditujukan untuk model yang tidak muat di memori satu mesin. Selama ini pilihannya hanya memperkecil model lebih jauh atau menyerahkan permintaan ke cloud. Kini ada jalan ketiga: menyambungkan satu mesin lagi.
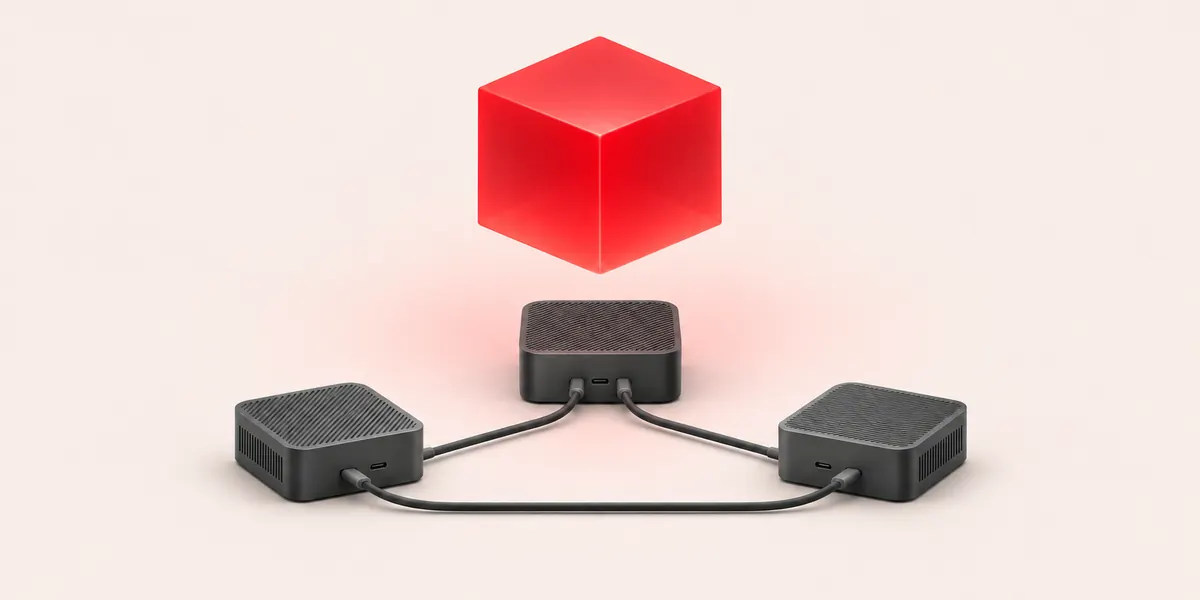
Tiga mini PC menjalankan model 235B
Microsoft menerbitkan dua set demo, masing-masing untuk AMD dan Intel.
| Konfigurasi | Model | Kecepatan generasi |
|---|---|---|
| 3 unit Ryzen AI Max+ 395, masing-masing 128GB | Qwen3-235B-A22B (terkuantisasi 4-bit) | 18,5 hingga 21,98 token/detik |
| 3 unit Core Ultra Series 3, masing-masing 64GB | GPT-OSS-120B | 49,4 token/detik |
| 4 unit Core Ultra Series 3, masing-masing 64GB | GPT-OSS-120B | 54,2 token/detik |
Konfigurasi AMD memakai mini PC dengan grafis terintegrasi Radeon 8060S dan memori terpadu 128GB per unit. Angka 18,5 diukur sendiri oleh Microsoft, sedangkan 21,98 adalah hasil AMD dengan konfigurasinya sendiri. Pada demo Intel, penambahan dari tiga menjadi empat mesin menaikkan kecepatan dari 49,4 ke 54,2, sehingga satu mesin tambahan hanya memberi peningkatan kurang dari 10%.
Hitungan kasar menunjukkan mengapa mesin perlu digabung. Dengan 235 miliar parameter yang disimpan dalam 4-bit, bobotnya saja mendekati 118GB. Di satu mesin 128GB, ruang tersisa untuk konteks dan sistem nyaris habis; dibagi ke tiga mesin, barulah ada ruang untuk konteks panjang. Ini perkiraan berdasarkan jumlah parameter. Penggunaan sebenarnya bergantung pada format kuantisasi dan panjang konteks, dan Microsoft tidak mengumumkan penggunaan memori tiap node.
Cepat karena melewati tumpukan jaringan
RDMA, singkatan dari remote direct memory access, memindahkan data antarmesin dengan melewati sebagian besar perangkat lunak jaringan biasa. Angka dari Microsoft menyebut latensi bolak-balik untuk pesan kecil sekitar 28 hingga 50 mikrodetik, kira-kira empat kali lebih cepat daripada UDP pada tautan USB4 yang sama. Kecepatan tautan mendukung dua tingkat, 40Gbps dan 80Gbps, dan port Thunderbolt 4 serta Thunderbolt 5 yang kompatibel juga bisa dipakai.
Inferensi terdistribusi sangat peka terhadap latensi. Ketika model dibagi ke beberapa mesin, hasil antara harus bolak-balik antarmesin setiap kali satu token dihasilkan, sehingga transfer yang sedikit lebih lambat akan menurunkan kecepatan secara keseluruhan.
Cara pemasangan kabel punya aturan. Microsoft mensyaratkan setiap PC terhubung langsung ke semua PC lainnya: untuk tiga mesin, tiap mesin memakai dua port USB4 dan total dibutuhkan tiga kabel. Menurut aturan yang sama, empat mesin berarti tiga port per mesin dan enam kabel. Microsoft secara khusus mengingatkan bahwa menyambung mesin secara berantai membuat performa turun jelas. Jumlah port USB4 pada PC konsumen terbatas, sehingga kami memperkirakan batas skala solusi ini sekitar empat atau lima mesin.
Dibandingkan solusi dengan NIC khusus
RDMA sudah bertahun-tahun dipakai di server dan klaster AI, dan Windows maupun Linux sudah lama mendukungnya, tetapi selalu memerlukan perangkat keras khusus. ServeTheHome sebelumnya memperagakan klaster Nvidia GB10 delapan node dengan total memori 1TB, memakai kartu jaringan ConnectX-7 dan Ethernet 200Gbps melalui protokol RoCE. Kecepatan tautan solusi itu beberapa kali lipat USB4, dengan konsekuensi setiap mesin harus punya NIC khusus ditambah satu switch.
Apple menempuh jalur yang mirip dengan Microsoft. Akhir tahun lalu, Apple membuka RDMA untuk Thunderbolt 5 di macOS, dan setelah itu cara menumpuk beberapa Mac untuk menjalankan model besar makin banyak dipakai. Di kubu Windows, VideoCardz menyebut satu detail: PC seri RTX Spark tidak memiliki antarmuka ConnectX-7 seperti DGX Spark, dan fitur Microsoft ini justru membidik mesin semacam itu, termasuk mini PC AMD Strix Halo dan Gorgon Halo.
Dari perbandingan ini, posisi solusi USB4 menjadi jelas: bandwidth dan skalabilitasnya tak bisa menandingi cara di ruang server, tetapi keunggulannya adalah tidak perlu menambah perangkat keras apa pun, sehingga tim kecil dan individu yang punya dua atau tiga PC baru bisa langsung mencobanya.
Kapan bisa dipakai
Fitur ini belum ada di versi Windows yang tersedia untuk publik saat ini. Microsoft berencana mendistribusikannya lewat kanal Experimental Windows Insider, dengan tanggal yang belum diumumkan. NetworkDirect provider di tingkat dasar dan versi llama.cpp yang sudah dimodifikasi sebagai kerangka inferensi telah dirilis sebagai sumber terbuka, sehingga pengembang yang ingin mencoba lebih awal dapat melihat kodenya.
Ada pula beberapa hal yang belum dijelaskan Microsoft: chip pengendali USB4 mana saja yang masuk daftar dukungan, apakah mesin dari merek berbeda dapat dihubungkan campuran, dan kapan alat populer seperti Ollama dan LM Studio akan menyusul. Demo semuanya memakai chip generasi baru, dan apakah PC USB4 yang lebih lama dapat memakainya baru akan terlihat dari pengujian nyata setelah versi pratinjau dirilis.
Sumber: blog teknologi USB Microsoft, VideoCardz, CocoLoop; kami mencocokkan konfigurasi mesin, model yang dijalankan, dan jumlah token per detik pada tiga demo, serta latensi bolak-balik dan persyaratan pemasangan kabel.