
Microsoft a publié l'aperçu développeur de RDMA over USB4 pour Windows. Plusieurs ordinateurs Windows peuvent être reliés par de simples câbles USB4 et mettre en commun leur mémoire et leurs GPU pour exécuter un même grand modèle en local, sans carte réseau RDMA dédiée, sans commutateur ni pilote tiers.
La technologie vise les modèles qui ne tiennent pas dans la mémoire d'une seule machine. Jusqu'ici, il fallait alors compresser davantage le modèle ou envoyer les requêtes vers le cloud ; il existe désormais une autre voie : brancher une machine de plus.
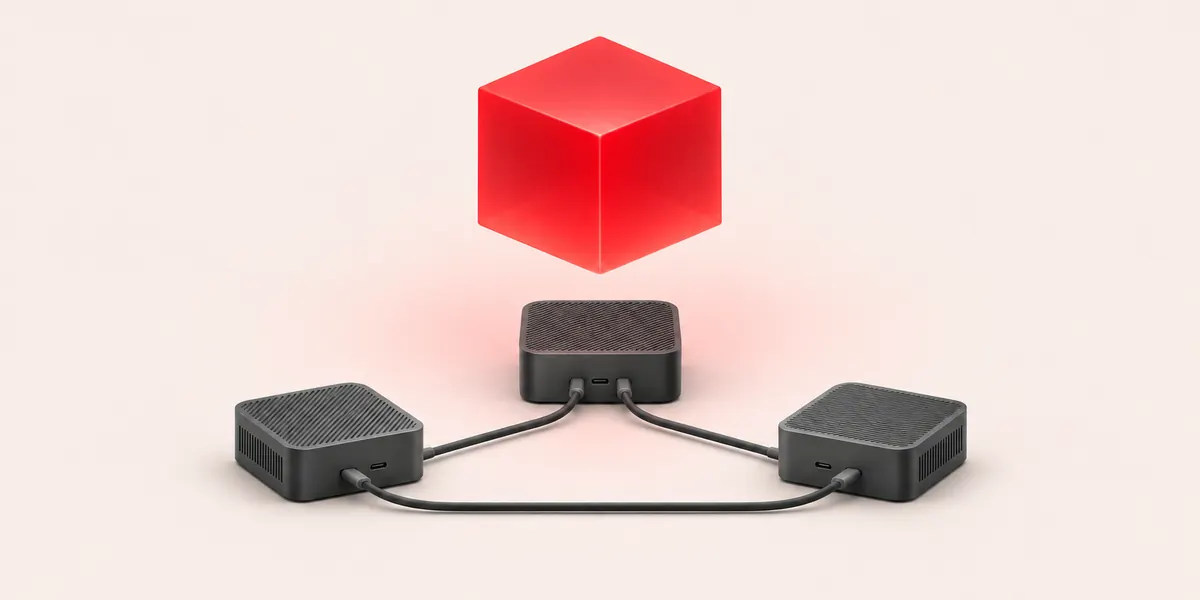
Trois mini-PC font tourner un modèle de 235B
Microsoft a présenté deux démonstrations, l'une d'AMD, l'autre d'Intel.
| Configuration | Modèle | Vitesse de génération |
|---|---|---|
| 3 Ryzen AI Max+ 395, 128 Go chacun | Qwen3-235B-A22B (quantification 4 bits) | 18,5 à 21,98 tokens/s |
| 3 Core Ultra Series 3, 64 Go chacun | GPT-OSS-120B | 49,4 tokens/s |
| 4 Core Ultra Series 3, 64 Go chacun | GPT-OSS-120B | 54,2 tokens/s |
Le groupe AMD utilise des mini-PC équipés d'un GPU intégré Radeon 8060S, avec 128 Go de mémoire unifiée par machine. Le chiffre de 18,5 a été mesuré par Microsoft ; celui de 21,98 vient d'AMD, avec sa propre configuration. Côté Intel, en passant de trois à quatre machines, la vitesse monte de 49,4 à 54,2 : une machine supplémentaire n'apporte pas dix pour cent de mieux.
Un calcul approximatif montre pourquoi il faut associer des machines : 235 milliards de paramètres stockés en 4 bits représentent près de 118 Go rien que pour les poids. Une fois chargés sur une machine de 128 Go, il reste très peu de marge pour le contexte et le système ; répartis sur trois machines, il y a de la place pour de longs contextes. Il s'agit d'une estimation fondée sur le nombre de paramètres ; l'occupation réelle dépend du format de quantification et de la longueur du contexte, et Microsoft n'a pas publié l'utilisation mémoire de chaque nœud.
Rapide car il contourne la pile réseau
RDMA signifie accès direct à la mémoire distante : lors du transfert de données entre deux machines, il contourne l'essentiel des logiciels réseau habituels. Selon Microsoft, la latence aller-retour des petits messages est d'environ 28 à 50 microsecondes, alors qu'UDP sur la même liaison USB4 est environ quatre fois plus lent. Les débits de liaison pris en charge sont de 40 Gbit/s et 80 Gbit/s, et les ports Thunderbolt 4 et Thunderbolt 5 compatibles fonctionnent également.
L'inférence distribuée est très sensible à la latence. Lorsqu'un modèle est découpé sur plusieurs machines, pour chaque token généré les résultats intermédiaires doivent faire un tour entre les machines ; si la transmission est un peu plus lente, la vitesse globale chute.
Le câblage obéit à des règles précises. Microsoft exige que chaque ordinateur soit relié directement à tous les autres : avec trois machines, chacune occupe deux ports USB4 et il faut trois câbles au total ; selon la même règle, quatre machines demandent trois ports par machine et six câbles. Microsoft prévient expressément que relier les machines en chaîne dégrade nettement les performances. Les ports USB4 des PC grand public étant peu nombreux, nous estimons que la limite de cette solution se situe autour de quatre ou cinq machines.
Comparaison avec les solutions à carte dédiée
RDMA est utilisé depuis des années dans les serveurs et les clusters d'IA, et Windows comme Linux le prennent en charge depuis longtemps, mais toujours avec du matériel dédié. ServeTheHome a présenté auparavant un cluster de huit nœuds NVIDIA GB10 totalisant 1 To de mémoire, avec des cartes ConnectX-7 et de l'Ethernet 200 Gbit/s sous protocole RoCE. Le débit de liaison de cette solution est plusieurs fois supérieur à celui de l'USB4 ; en contrepartie, chaque machine doit avoir une carte réseau dédiée, et il faut en plus un commutateur.
Apple suit une voie proche de celle de Microsoft : à la fin de l'année dernière, la firme a ouvert RDMA pour Thunderbolt 5 dans macOS, et l'empilement de plusieurs Mac pour faire tourner de grands modèles s'est depuis répandu. Côté Windows, VideoCardz relève un détail : les ordinateurs de la série RTX Spark n'ont pas l'interface ConnectX-7 du DGX Spark, et cette fonction de Microsoft vise précisément ce type de machines, ainsi que les mini-PC AMD Strix Halo et Gorgon Halo.
La place de la solution USB4 est ainsi claire : elle ne rivalise ni en bande passante ni en extensibilité avec ce qui se fait en salle serveurs, mais elle n'exige aucun matériel supplémentaire, et les petites équipes comme les particuliers disposant de deux ou trois machines récentes peuvent l'essayer.
Quand sera-t-elle disponible
Les versions publiques actuelles de Windows ne contiennent pas encore cette fonction. Microsoft prévoit de la diffuser via le canal Experimental de Windows Insider, sans date annoncée. Le NetworkDirect provider sous-jacent et une version modifiée du framework d'inférence llama.cpp sont déjà open source, et les développeurs qui veulent s'y essayer plus tôt peuvent consulter le code.
Plusieurs points restent aussi sans réponse chez Microsoft : quels contrôleurs USB4 figurent sur la liste de compatibilité, si l'on peut mélanger des machines de marques différentes, et quand des outils courants comme Ollama et LM Studio suivront. Les démonstrations utilisent toutes des puces de nouvelle génération ; savoir si des ordinateurs USB4 plus anciens conviennent ne pourra se vérifier qu'avec des tests réels une fois l'aperçu disponible.
Sources : blog technique USB de Microsoft, VideoCardz, CocoLoop ; ont été vérifiés la configuration des machines, les modèles et les tokens par seconde des trois démonstrations, ainsi que la latence aller-retour et les exigences de câblage.