
Microsoft ha publicado la vista previa para desarrolladores de RDMA over USB4 para Windows. Varios ordenadores con Windows pueden conectarse con cables USB4 corrientes y juntar su memoria y sus GPU para ejecutar un mismo gran modelo local, sin tarjetas de red RDMA específicas, conmutadores ni controladores de terceros.
Está pensado para modelos que no caben en la memoria de un solo equipo. Hasta ahora, en ese caso había que comprimir más el modelo o enviar las solicitudes a la nube; ahora hay otra opción: conectar una máquina más.
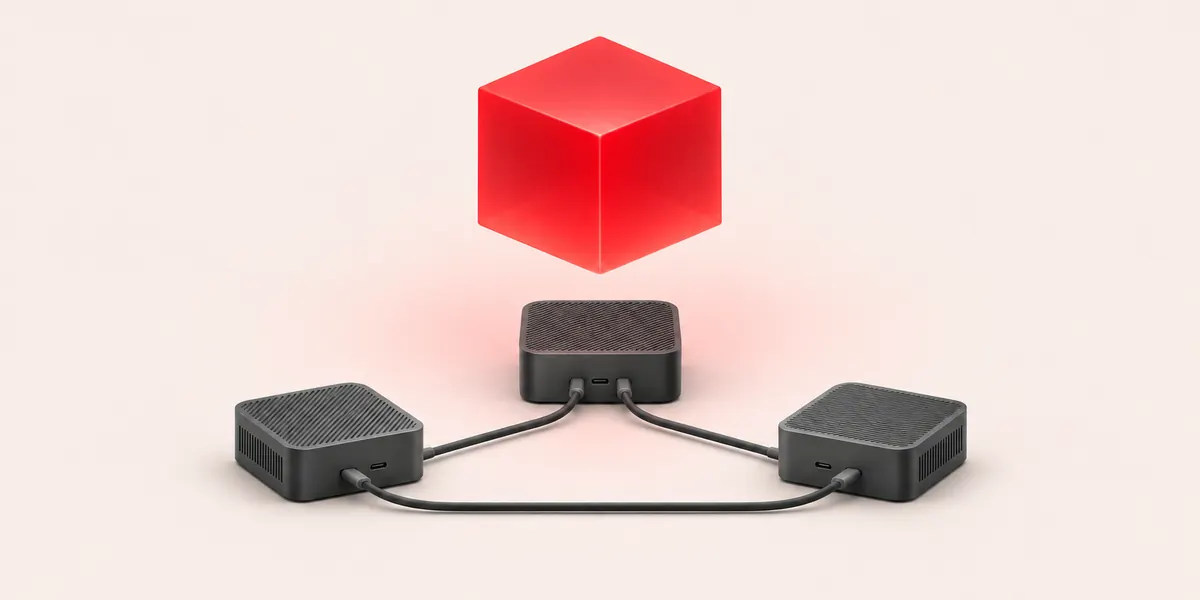
Tres miniPC ejecutan un modelo de 235B
Microsoft ha mostrado dos demostraciones, una de AMD y otra de Intel.
| Configuración | Modelo | Velocidad de generación |
|---|---|---|
| 3 Ryzen AI Max+ 395, 128 GB cada uno | Qwen3-235B-A22B (cuantización de 4 bits) | 18,5 a 21,98 tokens/s |
| 3 Core Ultra Series 3, 64 GB cada uno | GPT-OSS-120B | 49,4 tokens/s |
| 4 Core Ultra Series 3, 64 GB cada uno | GPT-OSS-120B | 54,2 tokens/s |
El grupo de AMD usa miniPC con GPU integrada Radeon 8060S y 128 GB de memoria unificada por equipo. La cifra de 18,5 la midió la propia Microsoft; la de 21,98 la obtuvo AMD con su configuración. En el grupo de Intel, al pasar de tres a cuatro equipos la velocidad sube de 49,4 a 54,2: una máquina más aporta una mejora de menos del diez por ciento.
Un cálculo aproximado muestra por qué hay que sumar máquinas: 235 000 millones de parámetros almacenados en 4 bits ocupan casi 118 GB solo en pesos. En un equipo de 128 GB, tras cargarlo queda muy poco margen para el contexto y el sistema; repartido entre tres hay espacio para contextos largos. Es una estimación basada en el número de parámetros; el consumo real depende del formato de cuantización y de la longitud del contexto, y Microsoft no ha publicado el uso de memoria de cada nodo.
Rápido porque esquiva la pila de red
RDMA son las siglas de acceso directo remoto a memoria: al mover datos entre dos máquinas, se salta la mayor parte del software de red convencional. Según Microsoft, la latencia de ida y vuelta de mensajes pequeños ronda los 28 a 50 microsegundos, mientras que UDP sobre el mismo enlace USB4 es unas cuatro veces más lento. Las velocidades de enlace admitidas son 40 Gbps y 80 Gbps, y los puertos Thunderbolt 4 y Thunderbolt 5 compatibles también sirven.
La inferencia distribuida es muy sensible a la latencia. Cuando un modelo se reparte entre varias máquinas, por cada token generado los resultados intermedios tienen que viajar una vez entre ellas; si la transmisión es algo más lenta, la velocidad global cae.
El cableado tiene sus reglas. Microsoft exige que cada ordenador esté conectado directamente con todos los demás: con tres equipos, cada uno ocupa dos puertos USB4 y hacen falta tres cables en total; siguiendo la misma regla, con cuatro equipos serían tres puertos por máquina y seis cables. Microsoft advierte expresamente de que conectar los equipos en cadena reduce el rendimiento de forma notable. Como los PC de consumo tienen pocos puertos USB4, estimamos que el límite de esta solución rondará los cuatro o cinco equipos.
Comparación con las soluciones de tarjeta dedicada
RDMA se usa desde hace años en servidores y clústeres de IA, y Windows y Linux lo admiten desde hace tiempo, pero siempre con hardware específico. ServeTheHome mostró antes un clúster de ocho nodos NVIDIA GB10 con 1 TB de memoria en total, con tarjetas ConnectX-7 y Ethernet de 200 Gbps mediante el protocolo RoCE. La velocidad de enlace de esa solución es varias veces la de USB4; a cambio, cada máquina necesita una tarjeta de red dedicada y hace falta además un conmutador.
Apple sigue un camino parecido al de Microsoft: a finales del año pasado abrió RDMA para Thunderbolt 5 en macOS, y desde entonces se ha extendido la práctica de apilar varios Mac para ejecutar grandes modelos. Por el lado de Windows, VideoCardz señala un detalle: los equipos de la serie RTX Spark no tienen la interfaz ConnectX-7 del DGX Spark, y esta función de Microsoft apunta precisamente a ese tipo de equipos, además de a los miniPC AMD Strix Halo y Gorgon Halo.
En la comparación, el lugar de la solución USB4 queda claro: no iguala el ancho de banda ni la escalabilidad de lo que se hace en un centro de datos, pero no requiere añadir hardware, y los equipos pequeños o los particulares con dos o tres ordenadores nuevos pueden probarla.
Cuándo estará disponible
Las versiones públicas actuales de Windows todavía no incluyen esta función. Microsoft prevé distribuirla a través del canal Experimental de Windows Insider, sin fecha anunciada. El NetworkDirect provider de bajo nivel y una versión modificada del marco de inferencia llama.cpp ya son de código abierto, y los desarrolladores que quieran probarlo antes pueden revisar el código.
Hay también varios puntos que Microsoft no ha aclarado: qué controladores USB4 figuran en la lista de compatibilidad, si se pueden mezclar equipos de distintas marcas y cuándo se sumarán herramientas habituales como Ollama y LM Studio. Las demostraciones usan chips de nueva generación; si los ordenadores USB4 más antiguos sirven, solo se sabrá con pruebas reales cuando se publique la vista previa.
Fuentes: blog técnico de USB de Microsoft, VideoCardz, CocoLoop; se contrastaron la configuración de los equipos, los modelos y los tokens por segundo de las tres demostraciones, así como la latencia de ida y vuelta y los requisitos de cableado.