
Microsoft 釋出了 Windows 版 RDMA over USB4 的開發者預覽。幾台 Windows 電腦只要用一般 USB4 線連起來,就能把各自的記憶體和 GPU 湊在一起,跑同一個本機大型模型,不需要專用的 RDMA 網路卡、交換器,也不需要第三方驅動程式。
它針對的是單機記憶體塞不下的模型。過去遇到這種情況,要嘛把模型壓得更小,要嘛把請求交給雲端;現在多了一條路,再接一台機器。
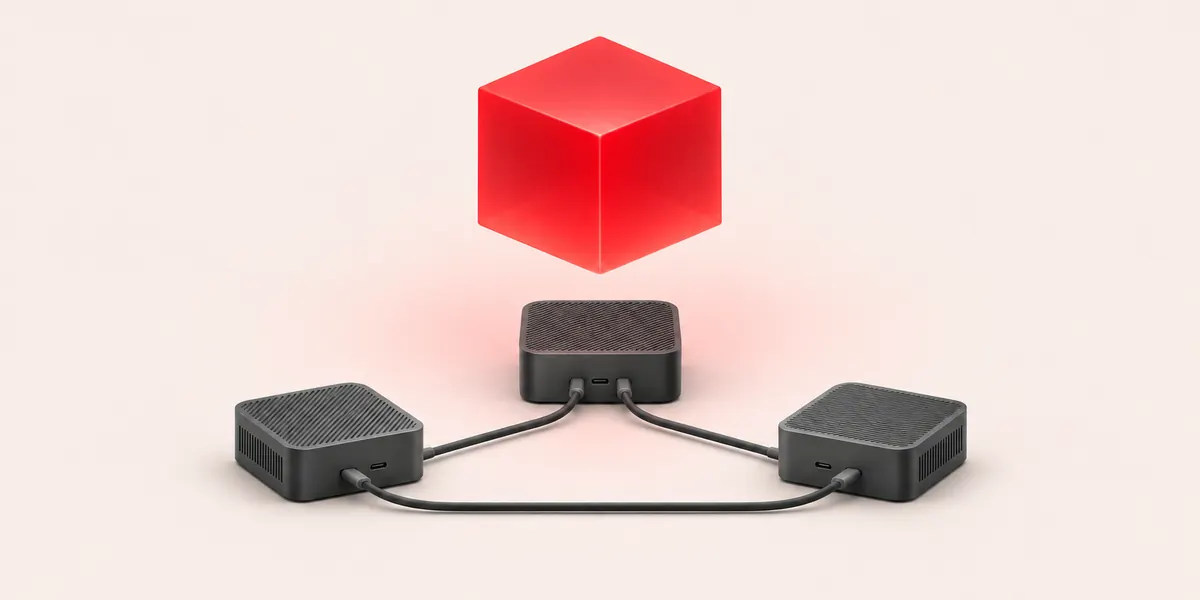
三台迷你主機跑 235B
Microsoft 公布了兩組展示,AMD 和英特爾各一組。
| 配置 | 模型 | 生成速度 |
|---|---|---|
| 3 台 Ryzen AI Max+ 395,每台 128GB | Qwen3-235B-A22B(4-bit 量化) | 18.5 至 21.98 token/秒 |
| 3 台 Core Ultra Series 3,每台 64GB | GPT-OSS-120B | 49.4 token/秒 |
| 4 台 Core Ultra Series 3,每台 64GB | GPT-OSS-120B | 54.2 token/秒 |
AMD 這組用的是搭載 Radeon 8060S 內顯的迷你主機,每台配備 128GB 統一記憶體。18.5 是 Microsoft 自己測的數字,21.98 是 AMD 用自家配置跑出來的。英特爾那組從三台增加到四台,速度從 49.4 升到 54.2,多一台機器換來的提升不到一成。
粗略算一下就能看出為什麼要拼機器:2,350 億個參數以 4-bit 儲存,光權重就接近 118GB,塞進一台 128GB 的機器後,留給上下文和系統的餘裕所剩無幾,分到三台上才有空間跑長上下文。這是依參數量做的估算,實際占用還取決於量化格式與上下文長度,Microsoft 並未公布各節點的記憶體占用。
快在繞過網路堆疊
RDMA 全名為遠端直接記憶體存取,資料在兩台機器之間搬運時,會繞過大部分一般的網路軟體。Microsoft 給的數字是,小訊息的往返延遲約 28 到 50 微秒,同一條 USB4 連結上走 UDP 要慢四倍左右。連結速率支援 40Gbps 與 80Gbps 兩檔,相容的 Thunderbolt 4、Thunderbolt 5 連接埠也能使用。
分散式推論對延遲很敏感。一個模型切到幾台機器上,每生成一個 token,中間結果都得在機器之間傳一輪,傳輸慢一點,速度就整體往下掉。
接線方式有講究。Microsoft 要求每台電腦與其他每一台直接相連:三台機器,每台要占兩個 USB4 埠,一共三條線;照這個規則推算,四台就是每台三個埠、六條線。Microsoft 特別提醒,把機器串成一條鏈會讓效能明顯下降。消費級電腦的 USB4 埠數量有限,我們估計這套方案的規模上限大約在四、五台。
和專用網卡方案比較
RDMA 在伺服器與 AI 叢集裡已用了很多年,Windows 和 Linux 早就支援,只是一直得靠專用硬體。ServeTheHome 先前展示過一套八節點的 Nvidia GB10 叢集,合計 1TB 記憶體,使用 ConnectX-7 網卡與 200Gbps 乙太網路,走 RoCE 協定。那套方案的連結速率是 USB4 的數倍,代價是每台機器都得有專用網卡,外加一台交換器。
蘋果走的是和 Microsoft 相近的路線,去年底在 macOS 中替 Thunderbolt 5 開放了 RDMA,幾台 Mac 堆疊起來跑大模型的玩法隨後多了起來。Windows 陣營這邊,VideoCardz 提到一個細節:RTX Spark 系列電腦沒有 DGX Spark 那樣的 ConnectX-7 介面,Microsoft 這項功能瞄準的正是這類機器,也包括 AMD 的 Strix Halo、Gorgon Halo 迷你主機。
比較下來,USB4 方案的定位很清楚:頻寬與擴充性比不上機房裡的做法,勝在不用加任何硬體,手邊有兩三台新電腦的小型團隊和個人就能試。
什麼時候能用
目前公開的 Windows 版本裡還沒有這項功能。Microsoft 計畫透過 Windows Insider 的 Experimental 管道推送,具體日期未公布。底層的 NetworkDirect provider 和一份修改過的 llama.cpp 推論框架已經開源,想提前研究的開發者可以先看程式碼。
還有幾件事 Microsoft 沒有說明:哪些 USB4 控制晶片在支援名單內、不同品牌的機器能不能混接、Ollama 與 LM Studio 這類常用工具何時跟進。展示用的都是新一代晶片,較舊的 USB4 電腦是否適用,要等預覽版釋出後才有實測。
參考來源:Microsoft USB 技術部落格、VideoCardz、CocoLoop;核對三組展示的機器配置、所跑模型與每秒 token 數,以及往返延遲和接線要求。